Close Menu
رسانه تخصصی هوش مصنوعی سیمرغرسانه تخصصی هوش مصنوعی سیمرغ
  • منشور اخلاقی سیمرغ
  • درباره ما
  • ارتباط با ما
  • آموزش و منابع آموزشی
    • کاربردهای هوش مصنوعی در صنایع
    • کتاب های هوش مصنوعی
    • مقالات هوش مصنوعی
  • رویدادها
    • دوره های آموزشی
    • سمینار
    • کارگاه
    • کنفرانس
    • مصاحبه‌ها
X (Twitter) Instagram YouTube LinkedIn Telegram
رسانه تخصصی هوش مصنوعی سیمرغرسانه تخصصی هوش مصنوعی سیمرغ
  • خانه
  • اخبار و مقالات
    • پزشکی
    • بازاریابی و تبلیغات
    • حمل و نقل
    • کشاورزی
    • حقوق و قضا
    • مالی و بانکی
    • هنر و خلاقیت
    • تولید و صنعت
    • آموزش
    • محیط زیست
    • بخش انرژی
    • امنیتی و دفاعی
    • مصاحبه‌ها
    • View All On Demos
  • رویدادها
    • سمینار
    • کنفرانس
    • وبینار
    • دوره های آموزشی
  • آموزش‌ها

    معرفی مدل دیپ‌سیک V۴.۱ با پنجره ۱ میلیونی و کاهش شدید هزینه کش

    شهریور 22, 1405

    راهنمای بهینه‌سازی پرامپت‌ها در جی پی تی ۶ آسترا

    شهریور 21, 1405

    ورود دستیار هوش مصنوعی به گوگل فوتوز

    شهریور 14, 1405

    محاسبه گر هوشمند استهلاک خودرو

    مرداد 27, 1405

    هوش مصنوعی Kimi K۳

    تیر 27, 1405
  • ابزارها
    1. چت‌بات‌ها و مدل‌های زبانی (LLMs & Chatbots)
    2. ابزارهای آموزش و یادگیری (Education & Learning AI)
    3. ابزارهای بهره‌وری و مدیریت (Productivity)
    4. ابزارهای تخصصی هوش مصنوعی (Advanced AI Tools)
    5. ابزارهای علم داده و دیتاساینس( Data Science & Analytics tools)
    6. ابزارهای امنیت، حریم خصوصی و سایبر (AI Security Tools)
    7. ابزارهای تحقیق، پژوهش و مقاله‌نویسی (AI Research Tools)
    8. ابزارهای بازاریابی و سئو (AI Marketing & SEO Tools)
    9. ابزارهای تولید صدا و موسیقی (AI Audio & Music Tools)
    10. ابزارهای کدنویسی و توسعه نرم‌افزار (AI Coding Tools)
    11. View All

    معرفی مدل دیپ‌سیک V۴.۱ با پنجره ۱ میلیونی و کاهش شدید هزینه کش

    شهریور 22, 1405

    راهنمای بهینه‌سازی پرامپت‌ها در جی پی تی ۶ آسترا

    شهریور 21, 1405

    مدل GPT-۶ Astra: تحولی در کدنویسی و امنیت سایبری

    شهریور 20, 1405

    OpenAI محدودیت چت رایگان ChatGPT را حذف کرد

    مرداد 16, 1405

    معرفی «Prism»: فضای کار ابری مبتنی بر هوش مصنوعی برای نوشتن مقالات علمی

    بهمن 19, 1404

    Google Illuminate: راز جدید گوگل برای یادگیری سریع

    آذر 14, 1404

    هوش مصنوعی NotebookLM

    آذر 13, 1404

    Google Scholar Labs | گوگل اسکولار لبز چیست؟

    آبان 29, 1404

    Claude Cowork برای نسخه‌های موبایل و وب عرضه می‌شود

    تیر 16, 1405

    بروزرسانی Google Workspace

    اردیبهشت 3, 1405

    معرفی «Prism»: فضای کار ابری مبتنی بر هوش مصنوعی برای نوشتن مقالات علمی

    بهمن 19, 1404

    راهنمای بهینه‌سازی پرامپت‌ها در جی پی تی ۶ آسترا

    شهریور 21, 1405

    هوش مصنوعی Grok ۴.۵

    تیر 18, 1405

    مدل‌های Gemma ۴ QAT : فشرده‌سازی مدل‌ها برای موبایل و لپ‌تاپ

    خرداد 16, 1405

    هوش مصنوعی GPT-۵.۴؛ مدل جدید OpenAI

    فروردین 17, 1405

    نسل جدید بینایی هوشمند با Gemini ۳ Pro

    آذر 16, 1404

    کلاد‌ای آی در نقش هکر

    تیر 11, 1405

    هوش مصنوعی Grok ۴.۵

    تیر 18, 1405

    هوش مصنوعی جما – Gemma ۴ گوگل

    فروردین 15, 1405

    معرفی «Prism»: فضای کار ابری مبتنی بر هوش مصنوعی برای نوشتن مقالات علمی

    بهمن 19, 1404

    دسترسی کامل‌تر به گوگل و امکانات پیشرفته‌تر با Google AI Pro

    بهمن 12, 1404

    مدل GPT-۶ Astra: تحولی در کدنویسی و امنیت سایبری

    شهریور 20, 1405

    هوش مصنوعی Grok ۴.۵

    تیر 18, 1405

    Tokenmaxxing | توکن‌مکسینگ یا «بیشینه‌سازی توکن»

    فروردین 29, 1405

    هوش مصنوعی GPT-۵.۴؛ مدل جدید OpenAI

    فروردین 17, 1405

    هوش مصنوعی جسم دارد/ندارد؟ Embodied AI

    خرداد 17, 1405

    کاربرد هوش مصنوعی در ردیابی گوشی گم‌شده: انقلابی در امنیت دیجیتال

    مهر 30, 1401

    تولید آیفون ۱۴، ۲۰ درصد گران‌تر از آیفون ۱۳ است

    مهر 30, 1401

    مایکروسافت قصد دارد نمای دسکتاپ یا موبایل را در نوار کناری Edge معرفی کند

    مهر 30, 1401
  • خرید اشتراک سالانه
  • ارتباط با ما
    • منشور اخلاقی سیمرغ
    • ارتباط با ما
    • درباره ما
  • اپلیکیشن سیمرغ GPT
Instagram YouTube LinkedIn Telegram
رسانه تخصصی هوش مصنوعی سیمرغرسانه تخصصی هوش مصنوعی سیمرغ
خانه - آموزش و منابع آموزشی - LLMs به زبان فارسی ساده

LLMs به زبان فارسی ساده

0
By سهراب اسکندری on اسفند 25, 1403 آموزش و منابع آموزشی, شاخص‌ها, کتاب های هوش مصنوعی, مقالات هوش مصنوعی
اشتراک‌ با دوستان
Facebook Twitter LinkedIn Pinterest Telegram Email WhatsApp Copy Link

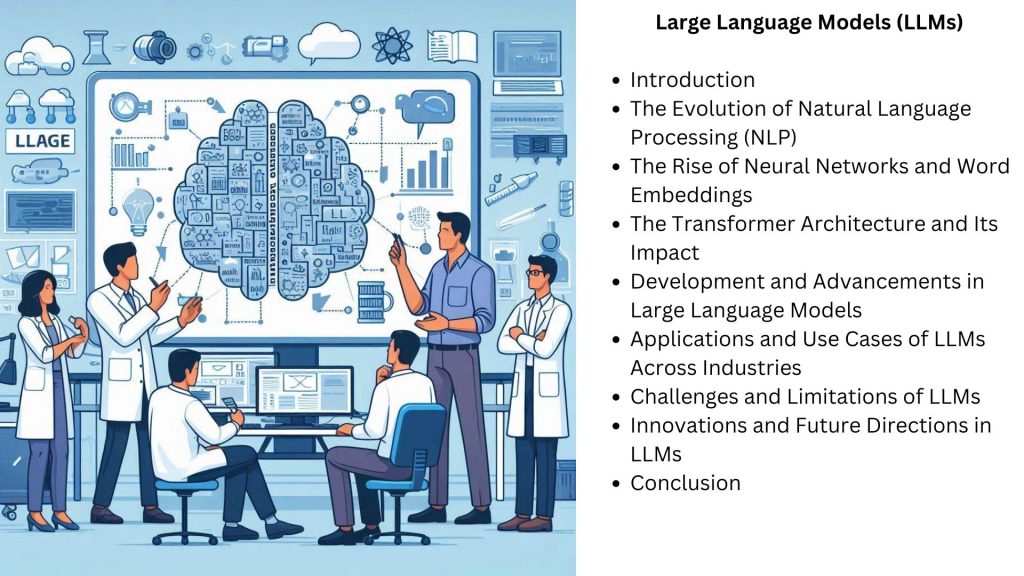
معرفی مدل‌های زبانی بزرگ LLMs به زبان فارسی ساده

  • معرفی مدل‌های تولید متن به زبان ساده؟
  • مبانی ریاضی مدل‌های زبانی بزرگ
  • معماری ترنسفورمر: موتور پردازش مدل‌های زبانی بزرگ
  • هزینه‌های محاسباتی و پیشرفت‌های سخت‌افزاری

مقدمه

مدل‌های زبانی بزرگ (LLMs) باعث ایجاد تحول عظیمی در هوش مصنوعی و فراهم آوردن امکان تولید متن‌هایی شده‌اند که شباهت زیادی به نوشتار انسانی دارند. برخلاف مدل‌های قدیمی‌تر که انعطاف‌پذیری کمتری داشتند، این مدل‌ها توانایی پردازش حجم عظیمی از داده‌ها را دارند و در حوزه‌های متنوعی مانند تولید محتوا، ساخت چت‌بات‌ها و خودکارسازی برنامه‌نویسی کاربرد دارند.

معرفی مدل‌های زبانی بزرگ LLMs به زبان فارسی ساده

معرفی مدل‌های تولید متن به زبان ساده؟

مدل‌های تولید متن، سیستم‌های پیشرفته‌ای از هوش مصنوعی هستند که برای درک و تولید متن طراحی شده‌اند. عملکرد اصلی آن‌ها بر پایه شکستن متن به واحدهای اساسی به نام توکن است. این توکن‌ها می‌توانند شامل کلمات کامل، زیرکلمات یا حتی کاراکترهای منفرد باشند. درک تعداد توکن‌های یک متن برای مدیریت محدودیت‌های پردازشی بسیار مهم است، زیرا مدل‌های مختلف ظرفیت توکنی متفاوتی دارند.

LLMs به زبان فارسی ساده
نزدیکی معنایی بردارهای کلمات – LLMs به زبان فارسی ساده

یکی از مراحل مهم پردازش اولیه در این مدل‌ها توکنیزه‌سازی است که متن را به قطعات کوچکتر تقسیم می‌کند تا پردازش آن کارآمدتر شود. رایج‌ترین روش‌های توکنیزه‌سازی عبارتند از:

  • Byte-Pair Encoding (BPE): کاراکترهای پرتکرار را به تدریج ترکیب کرده و توکن‌های جدیدی ایجاد می‌کند.
  • WordPiece: مشابه BPE اما برای کاهش شکستن غیرضروری کلمات نادر بهینه شده است.
  • SentencePiece: برای زبان‌هایی که از فاصله بین کلمات استفاده نمی‌کنند، کارآمد است.

به عنوان مثال، در روش BPE، ابتدا کلمه “apple” به صورت a, p, p, l, e دیده می‌شود، اما پس از پردازش‌های مکرر، ترکیب پرتکرار appl به عنوان یک توکن واحد در نظر گرفته می‌شود که کارایی مدل را افزایش می‌دهد.

مبانی ریاضی مدل‌های زبانی بزرگ

مدل‌های زبانی بزرگ، به جای اینکه کلمات را صرفاً به عنوان رشته‌هایی از حروف در نظر بگیرند، آن‌ها را به بردارهای عددی چندبعدی تبدیل می‌کنند که به آن word embeddings گفته می‌شود. این روش باعث می‌شود که کلماتی با معانی مشابه (مانند “اخلاق” و “فضیلت”) در فضای برداری نزدیک به هم قرار گیرند. این ساختار کمک می‌کند تا مدل‌ها بتوانند روابط بین کلمات، نحو زبان و زمینه معنایی را بهتر درک کنند.

معماری ترنسفورمر: موتور پردازش مدل‌های زبانی بزرگ

نوآوری کلیدی پشت مدل‌های زبانی مدرن، معماری ترنسفورمر است که اولین بار در مقاله‌ی معروف گوگل “Attention Is All You Need” در سال ۲۰۱۷ معرفی شد. برخلاف مدل‌های قدیمی‌تر که متن را به صورت ترتیبی پردازش می‌کردند، ترنسفورمرها از مکانیسم توجه خودکار (self-attention) برای پردازش همزمان تمام کلمات یک جمله استفاده می‌کنند.

به عنوان مثال، در جمله‌ی “گربه روی حصیر نشست“، مدل ترنسفورمر درک می‌کند که “گربه“ با “نشست“ مرتبط است، بدون اینکه نیاز باشد کلمات را به ترتیب بررسی کند. این قابلیت باعث بهبود درک مدل از زبان و روابط بین کلمات می‌شود.

نحوه تولید متن توسط مدل‌های زبانی بزرگ

پس از درک متن ورودی، مدل زبانی بزرگ کلمه بعدی را بر اساس احتمال وقوع آن پیش‌بینی می‌کند. این مدل‌ها برای هر کلمه‌ی ممکن یک مقدار احتمال اختصاص می‌دهند و گزینه‌ای که بالاترین احتمال را دارد، انتخاب می‌کنند. این فرآیند برای هر کلمه‌ی جدید تکرار می‌شود تا یک متن منسجم و معنادار تولید شود.

تحولات تاریخی در معماری ترنسفورمر

قبل از ظهور معماری ترنسفورمر، مدل‌های زبانی مانند شبکه‌های عصبی بازگشتی (RNNs) و حافظه بلندمدت کوتاه‌مدت (LSTMs) چالش‌های زیادی داشتند، از جمله:

  • پردازش ترتیبی ناکارآمد: این مدل‌ها متن را کلمه به کلمه پردازش می‌کردند که یادگیری وابستگی‌های بلندمدت را دشوار می‌کرد.
  • مشکل کاهش گرادیان: مدل‌های قدیمی در حفظ اطلاعاتی که در ابتدای متن بودند، دچار مشکل می‌شدند.
  • کارایی پایین در مقیاس‌های بزرگ: پردازش ترتیبی باعث افزایش زمان و هزینه‌ی محاسباتی می‌شد.

ورود مکانیسم توجه خودکار باعث شد که مدل‌ها بتوانند وابستگی‌های دوربرد را بهتر درک کنند و پردازش موازی را امکان‌پذیر سازند که به طرز چشمگیری کارایی را افزایش داد.

هزینه‌های محاسباتی و پیشرفت‌های سخت‌افزاری

آموزش مدل‌های زبانی بزرگ نیازمند منابع محاسباتی عظیمی است که معمولاً از سخت‌افزارهای خاصی استفاده می‌کنند:

  • واحدهای پردازش گرافیکی (GPUs): پردازش ماتریسی را که در یادگیری عمیق ضروری است، بهینه می‌کنند.
  • واحدهای پردازش تنسور (TPUs): تراشه‌های اختصاصی گوگل برای پردازش‌های مرتبط با هوش مصنوعی.
  • ابررایانه‌ها و مراکز پردازشی با عملکرد بالا: برای آموزش مدل‌های بسیار بزرگ استفاده می‌شوند.

به عنوان مثال، آموزش GPT-4 حدود ۱.۷ تریلیون پارامتر را دربر گرفت و هزینه‌ی محاسباتی آن به ۶۳ میلیون دلار رسید. این نیاز شدید به محاسبات باعث رقابت شدید در بین شرکت‌های سخت‌افزاری شده است، به ویژه NVIDIA که در بازار پردازنده‌های گرافیکی پیشرفته تسلط دارد.

جمع‌بندی و آینده‌ی مدل‌های زبانی بزرگ

تحولات مدل‌های زبانی از معماری‌های قدیمی تا سیستم‌های پیچیده امروزی نشان از پیشرفت چشمگیر در هوش مصنوعی دارند. مدل‌های جدید نه‌تنها درک بهتری از زبان دارند، بلکه قابلیت‌های چندوجهی (متن، تصویر، صوت) را نیز در بر می‌گیرند. آینده‌ی این مدل‌ها شامل:

  • بهبود دقت و کاهش خطاهای زبانی.
  • مدل‌های بهینه‌تر برای اجرا روی دستگاه‌های شخصی.
  • افزایش نقش هوش مصنوعی در پردازش زبان طبیعی در حوزه‌های تخصصی مانند پزشکی و حقوق.

منبع: کتاب مهندسی پرامپت نوشته جیمز فونیکس و مایک تیلور
تلگرام
س
سهراب اسکندری دنبال‌شده
۶ دنبال‌کننده دنبال‌کردن در لینکدین
تلگرام واتساپ ایکس
نظرت چیه؟
مدل‌های زبانی بزرگ(LLMs)
Share. Facebook Twitter Pinterest LinkedIn Tumblr Email
Previous Articleبیش از ۱۰۰ پرامپت آماده هوش مصنوعی
Next Article استانداردهای طلایی تولید متن با ChatGPT

پست‌های مشابه

هشدار کارمند سابق درباره هوش مصنوعی؛ واکنش مدیران شرکت‌های بزرگ

گوگل به سرقت کد متن باز مینی تپ گوگل در پروژه هوش مصنوعی آرتمیس متهم شد

ابلاغ قانون توسعه هوش مصنوعی از سوی رئیس مجلس به رئیس‌جمهور

معرفی مدل دیپ‌سیک V۴.۱ با پنجره ۱ میلیونی و کاهش شدید هزینه کش

جزئیات طرح مهار هوش مصنوعی از سوی مدیرعامل آنتروپیک اعلام شد

قابلیت‌های تعاملی خان‌میگو و جمنای برای یادگیری ریاضی و علوم

Add A Comment
Leave A Reply Cancel Reply

برای نوشتن دیدگاه باید وارد بشوید.

پیشنهاد ویژه محصولات هوشمند سیمرغ
درباره رسانه هوش مصنوعی سیمرغ

در رسانه تخصصی هوش مصنوعی سیمرغ، ما فراتر از یک پایگاه خبری عمل می‌کنیم. ما آینده‌ای نوین را با قدرت دانش و فناوری می‌سازیم. از تحلیل عمیق جدیدترین پیشرفت‌های هوش مصنوعی تا معرفی ابزارهای نوآورانه، رسالت ما این است که جامعه‌ای آگاه و پیشرو در این حوزه ایجاد کنیم.

🌍 بزرگترین جامعه هوش مصنوعی خاورمیانه
📡 آخرین اخبار، تحلیل‌ها و آموزش‌های تخصصی
🚀 همراهی با متخصصان، استارتاپ‌ها و علاقه‌مندان هوش مصنوعی

🔗 همین حالا به سیمرغ بپیوندید و آینده را با ما رقم بزنید!
📩 تماس با ما: [email protected]
🌐 وب‌سایت: simorghai.ir

X (Twitter) Instagram YouTube LinkedIn Discord Telegram
درباره ما ارتباط با ما منشور اخلاقی سیمرغ راهنمای خبرنگاران افتخاری
      📩 عضویت در خبرنامه لینکدین
لوگو خبری رسانه هوش مصنوعی سیمرغ لوگو خبری رسانه هوش مصنوعی سیمرغ
logo-samandehi
نوشته‌های تازه
  • هشدار کارمند سابق درباره هوش مصنوعی؛ واکنش مدیران شرکت‌های بزرگ
  • گوگل به سرقت کد متن باز مینی تپ گوگل در پروژه هوش مصنوعی آرتمیس متهم شد
  • ابلاغ قانون توسعه هوش مصنوعی از سوی رئیس مجلس به رئیس‌جمهور
  • معرفی مدل دیپ‌سیک V۴.۱ با پنجره ۱ میلیونی و کاهش شدید هزینه کش
  • جزئیات طرح مهار هوش مصنوعی از سوی مدیرعامل آنتروپیک اعلام شد
رسانه تخصصی هوش مصنوعی سیمرغ
X (Twitter) Instagram YouTube LinkedIn Telegram WhatsApp
بازنشر مطالب هوش مصنوعی سیمرغ تحت هر عنوانی غیر مجاز و پیگرد قانونی دارد.
طراحی شده توسط سیمرغ ای آی © 1405.

Type above and press Enter to search. Press Esc to cancel.

ورود به حساب کاربری

برای ادامه، وارد حساب کاربری خود شوید

ورود با گوگل
یا
#
رمز عبور را فراموش کرده‌اید؟

حساب کاربری ندارید؟ ثبت‌نام کنید

کد اپلیکیشن احرازکننده یا یکی از کدهای پشتیبان را وارد کنید

افزونه مسدود کننده تبلیغات شما فعال است!
وب‌سایت ما با نمایش تبلیغات آنلاین به بازدیدکنندگان‌ ادامه حیات میدهد! لطفاً با غیرفعال کردن افزونه مسدودکننده تبلیغات‌ مرورگرتان از تیم سیمرغ حمایت کنید.