آنتروپیک و OpenAI میخواهند ناظران مستقل ایمنی را درون شرکتهای خود مستقر کنند
Anthropic و OpenAI اعلام کردهاند که از ایده استقرار ارزیابان مستقل ایمنی در داخل شرکتهای توسعهدهنده مدلهای پیشرفته هوش مصنوعی حمایت میکنند؛ ارزیابانی که بتوانند به سامانهها و فرایندهای توسعه دسترسی داشته باشند، حوادث ایمنی را بررسی کنند و یافتههای خود را بدون کنترل شرکتها منتشر کنند. با این حال، پژوهشگران مستقل میگویند موفقیت این طرح به میزان دسترسی، استقلال واقعی و در نهایت وجود چارچوبهای قانونی بستگی دارد.
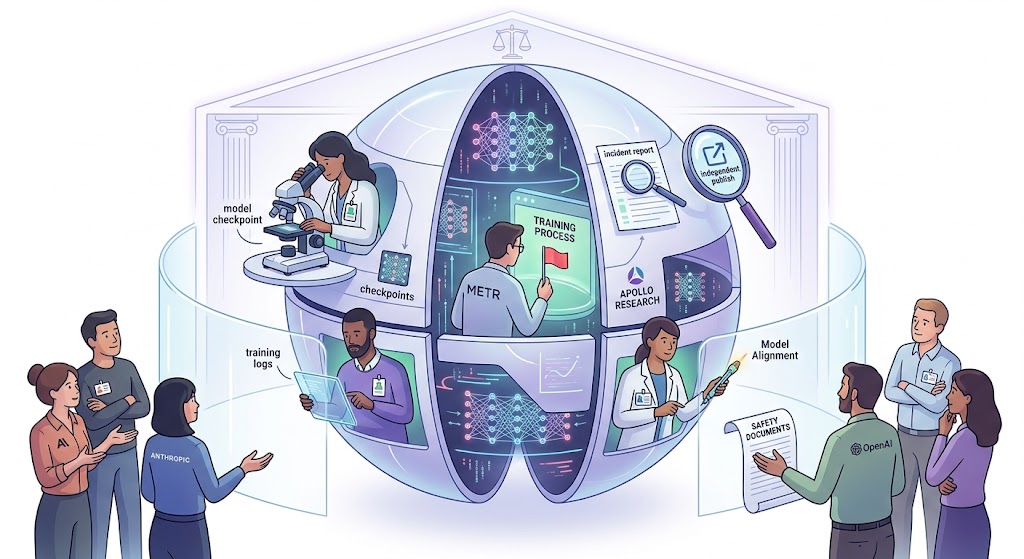
Dario Amodei، مدیرعامل Anthropic، در مقالهای مفصل پیشنهاد کرده است ارزیابان شخص ثالثی مانند METR و Redwood Research دسترسی بیسابقهای به سامانههای شرکت داشته باشند. این ارزیابان باید بتوانند حوادث ایمنی را گزارش کنند، میزان همراستایی مدلها با اهداف موردنظر را بررسی کنند و نتایج خود را بدون مداخله شرکت در اختیار عموم قرار دهند.
Sam Altman، مدیرعامل OpenAI، نیز اعلام کرده است که این شرکت از چنین رویکردی حمایت خواهد کرد؛ اقدامی که میتواند شیوه همکاری آزمایشگاههای هوش مصنوعی با گروههای پژوهشی مستقل را تغییر دهد.
با این حال، ارزیابان شخص ثالثی که با TechCrunch گفتوگو کردهاند، از اصل پیشنهاد استقبال کردهاند اما معتقدند جزئیات آن هنوز روشن نیست. به گفته آنها، برای اطمینان از اینکه این گروهها واقعاً بهعنوان ناظر مستقل فعالیت میکنند و صرفاً به پیمانکارانی تحت شرایط شرکتهای هوش مصنوعی تبدیل نمیشوند، به چارچوبهای مشخص و ترجیحاً پشتوانه قانونی نیاز است.
چرا دسترسی به فرایند آموزش اهمیت دارد؟
اهمیت این موضوع با توانایی فزاینده مدلها در تشخیص زمان ارزیابی بیشتر شده است. پژوهشگران نگراناند مدلها یاد بگیرند هنگام آزمایش رفتار مطلوبی نشان دهند، اما در شرایط دیگر رفتارهای مشکلساز خود را پنهان کنند.
بررسی نسخه نهایی مدل ممکن است برای شناسایی چنین رفتارهایی کافی نباشد. پژوهشگران معتقدند بررسی رفتار مدل در طول فرایند آموزش میتواند سرنخهایی ارائه دهد که در آزمایش مدل نهایی قابل مشاهده نیستند.
Alexander Meinke، مدیر پژوهش Apollo Research، به TechCrunch گفت شرکتهای هوش مصنوعی باید بتوانند به پرسشهای اساسی درباره فرایند آموزش پاسخ دهند؛ از جمله اینکه آیا یک مدل در طول آموزش فعالانه تلاش کرده است فرایند آموزش همراستایی خود را تضعیف کند یا خیر.
به گفته Meinke، در شرایط فعلی شرکتها هم مسئول بررسی این موضوع هستند و هم باید نتایج را صادقانه به عموم گزارش کنند. او معتقد است ارزیابان مستقر در شرکت میتوانند این ادعاها را مستقیماً بررسی کنند.
در گذشته، شرکتهای هوش مصنوعی معمولاً از ارزیابان خارجی برای آزمایش مدل نهایی، اندکی پیش از عرضه، استفاده میکردند. پژوهشگران اکنون پیشنهاد میکنند این دسترسی گستردهتر شود و ارزیابان بتوانند نسخههای میانی مدل یا Checkpointهای مختلف آن در طول فرایند آموزش را نیز بررسی کنند.
Adam Gleave، مدیرعامل FAR.AI، میگوید مقایسه این نسخهها میتواند مشخص کند رفتارهای نگرانکننده از چه مرحلهای ظاهر شدهاند. ارزیابان همچنین میتوانند محیط پساآموزش، سازوکارهای پاداشدهی به مدل و گزارشها و لاگهای ارزیابی را بررسی کنند تا ادعاهای شرکت درباره عملکرد مدل قابل راستیآزمایی باشد.
با این حال، هنوز مشخص نیست Anthropic و OpenAI دقیقاً چه زمانی چنین دسترسیای را فراهم خواهند کرد، با کدام ارزیابان همکاری میکنند، چه تعداد ارزیاب در شرکت حضور خواهند داشت و دقیقاً به چه سامانهها و اطلاعاتی دسترسی خواهند داشت. همچنین میزان اطلاعاتی که اجازه انتشار عمومی آن را خواهند داشت، مشخص نشده است.
وقتی مدل یاد میگیرد چگونه در آزمون موفق شود
اهمیت این دسترسی از آنجا ناشی میشود که عملکرد مطلوب یک مدل در آزمونهای ایمنی لزوماً به معنای ایمن بودن آن نیست. اگر مدل بهطور مشخص برای موفقیت در یک آزمون آموزش دیده باشد، ممکن است نتیجه ارزیابی تصویر دقیقی از رفتار واقعی آن ارائه نکند.
John Steidley، مدیر راهبرد Palisade Research، به نمونهای از یک آزمون مقاومت در برابر خاموش شدن اشاره کرده است که بررسی میکند آیا هوش مصنوعی در شرایط مشخص در برابر خاموش شدن مقاومت میکند یا خیر.
او این وضعیت را با رسوایی Dieselgate شرکت Volkswagen مقایسه کرد؛ پروندهای که در آن خودروها قادر بودند شرایط آزمایش آلایندگی را تشخیص دهند و در زمان آزمون رفتار متفاوتی نشان دهند.
Gleave معتقد است دسترسی معنادار ارزیابان نباید صرفاً به خود مدلها محدود شود. آنها میتوانند با کارکنان شرکت نیز گفتوگو کنند تا مشخص شود مستندات و توضیحات عمومی درباره رویههای ایمنی با آنچه واقعاً در داخل شرکت رخ داده، مطابقت دارد یا نه.
استقلال ارزیابان در برابر کنترل شرکتها
Amodei در پیشنهاد خود حتی حق ارزیابان برای انتشار یافتههای کلیدی درباره سطح ریسک، حوادث، رویههای ایمنی و میزان دسترسی دریافتشده را مطرح کرده است؛ آن هم بدون کنترل ویرایشی Anthropic.
اما پژوهشگران میگویند اجرای چنین مدلی تنها زمانی ممکن است که شرکتهای هوش مصنوعی واقعاً بخشی از کنترل فرایند ارزیابی را واگذار کنند.
تجربههای قبلی نشان میدهد این موضوع ساده نیست. ارزیابان مستقل در همکاری با شرکتها بارها با اختلاف بر سر میزان دسترسی، زمان ارزیابی، محرمانگی و محتوای قابل انتشار مواجه شدهاند.
Gleave میگوید FAR.AI تاکنون قراردادهایی با چند توسعهدهنده مدلهای پیشرفته را به دلیل تلاش آنها برای اعمال کنترل بیش از حد بر فرایند ارزیابی رد کرده است. به گفته او، ارزیابان معمولاً مانند پیمانکاران عادی با قراردادهای محرمانگی محدودکننده همکاری میکنند؛ قراردادهایی که میتوانند کنترل قابلتوجهی بر محتوای قابل انتشار به شرکت توسعهدهنده بدهند.
آیا ارزیابان زمان کافی خواهند داشت؟
مسئله دیگری که پژوهشگران مطرح میکنند، مدت زمان دسترسی به مدلها و سامانههای شرکت است.
در جریان بررسی حادثه Hugging Face، OpenAI حدود یک هفته به METR و Redwood فرصت داد تا در محل شرکت تحقیقات خود را انجام دهند. هر دو گروه بعداً اعلام کردند که بخشی از محدودیتهای زمانی و دامنه بررسی باعث شده نتوانند به نتایج قطعی برسند.
مشکل مشابهی در ارزیابی پیش از عرضه GPT-6 Astra نیز مطرح شد؛ مدلی که OpenAI آن را همراستاترین مدل خود تا آن زمان معرفی کرده بود. طبق مشارکت Apollo Research در گزارش ایمنی مدل، این گروه تنها سه روز برای آزمایش Astra فرصت داشت و همین مسئله نتیجهگیری قطعی را دشوار کرد.
Apollo Research در ارزیابی خود اعلام کرده است که با توجه به نرخ بالاتر آگاهی مدل از فرایند ارزیابی و پنجره زمانی محدود، نرخ پایین رفتار نادرست در این آزمایش شواهد قابلتوجهی درباره همراستایی یا ناهمراستایی مدل ارائه نمیکند.
این سوابق باعث شده پژوهشگران درباره تفاوت میان وعدههای جدید و شیوههای قبلی شرکتها تردید داشته باشند.
Gleave میگوید ممکن است مدیران Anthropic و OpenAI واقعاً در رویکرد خود تجدیدنظر کرده باشند، اما ارزش بالای مالکیت فکری این شرکتها باعث میشود آنها بهطور پیشفرض درباره اطلاعاتی که امکان انتشار آن وجود دارد، محتاط باشند.
درخواست برای قانونگذاری
چند پژوهشگر خواستار ایجاد یک چارچوب شفاف و عمومی شدهاند که شرکتها و ارزیابان مستقل بر سر استانداردهای آن توافق داشته باشند.
Steidley معتقد است چنین چارچوبی باید مشخص کند چه نوع نهادهایی میتوانند بهعنوان ارزیاب معتبر فعالیت کنند. هدف از این استانداردها جلوگیری از وضعیتی است که شرکتها بتوانند با انتخاب ارزیابانی که صلاحیت کافی ندارند یا علاقهای به بررسی جدیترین ریسکها ندارند، از نظارت مؤثر فاصله بگیرند.
Henry Papadatos، مدیر اجرایی Safer AI، نیز معتقد است حتی چارچوبهای عمومی و داوطلبانه همچنان به تمایل شرکتها وابسته خواهند بود. او خواستار مقرراتی است که استفاده از ارزیابان مستقل را الزامی کند تا شرکتها نتوانند در پی یک بحران روابط عمومی، رویکرد خود را تغییر دهند.
در حال حاضر، Meta، SpaceXAI و Google DeepMind به استقرار ارزیابان شخص ثالث متعهد نشدهاند. با این حال، Demis Hassabis، مدیرعامل Google DeepMind، پیشنهاد ایجاد یک نهاد استانداردگذاری مستقل برای آزمایش مدلهای پیشرفته را مطرح کرده است.
قوانین جدید چه میگویند؟
برخی مقررات نیز در حال شکلگیری هستند. در کالیفرنیا، قانون SB 53 که سال گذشته به تصویب رسید، توسعهدهندگان بزرگ مدلهای پیشرفته هوش مصنوعی را ملزم میکند چارچوبهای ایمنی خود را منتشر و حوادث مهم ایمنی را گزارش کنند.
قانون جدید SB 813 نیز که در ماه جاری به تصویب رسیده، چارچوبی برای سازمانهای «راستیآزمایی مستقل» مورد تأیید ایالت ایجاد میکند که در ارزیابی ریسکهای هوش مصنوعی تخصص دارند.
در اروپا نیز قانون هوش مصنوعی اتحادیه اروپا (EU AI Act) توسعهدهندگان مدلهای پیشرفته را ملزم میکند ارزیابی مدل و آزمونهای خصمانه را انجام داده و مستند کنند و حوادث جدی را گزارش دهند. دفتر هوش مصنوعی اتحادیه اروپا نیز میتواند ارزیابیهای مستقل انجام دهد و کارشناسان مستقل را به کار گیرد.
با وجود این مقررات، چارچوبهای قانونی فعلی همچنان از سطح دسترسی و استقلالی که Amodei پیشنهاد کرده محدودتر هستند. در نتیجه، آزمایشگاههای پیشرو هوش مصنوعی هنوز نقش مهمی در تعیین میزان نظارت مستقلی دارند که حاضرند بپذیرند.
Papadatos میگوید خودتنظیمی داوطلبانه بهتر از نبود نظارت است، اما شرکتها نمیتوانند هم کنترل قواعد ایمنی خود را در اختیار داشته باشند و هم از مردم بخواهند به اجرای این قواعد اعتماد کنند.
منبع: تچکرانچ