Qwen3.۸-Omni-Flash معرفی شد؛ مدل چندوجهی Qwen با تمرکز بر اجرای وظایف صوتی و ویدیویی
Alibaba مدل Qwen3.8-Omni-Flash را بهعنوان نسل جدید مدل بومی چندوجهی (Omnimodal) خود معرفی کرد؛ مدلی که علاوه بر درک متن، تصویر، صدا و ویدیو، برای برنامهریزی وظایف، استفاده از ابزارها و اجرای فرایندهای چندمرحلهای طراحی شده است. این مدل با پنجره زمینه یک میلیون توکنی عرضه شده و تمرکز ویژهای بر کاربردهای عملیاتی در حوزههایی مانند ویرایش ویدیو، تولید موزیکویدیو، ترجمه، تولید محتوای صوتیتصویری و تعامل بلادرنگ دارد.

درک همزمان متن، تصویر، صدا و ویدیو
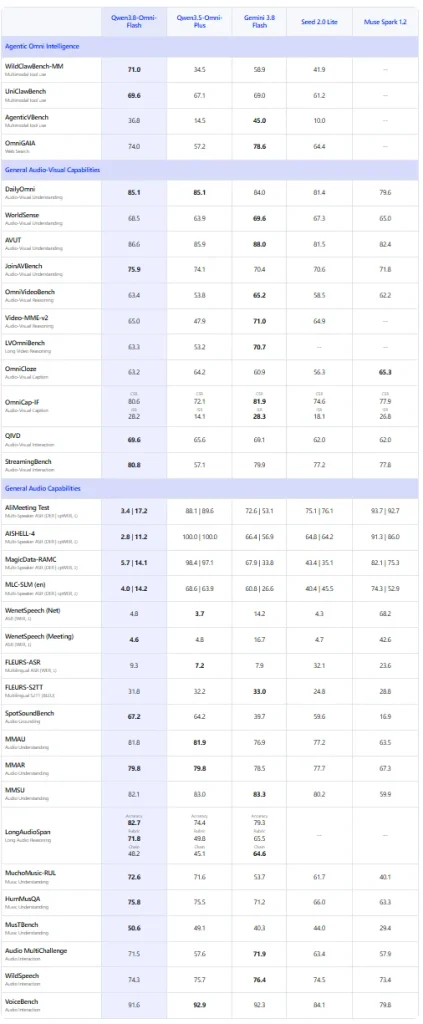
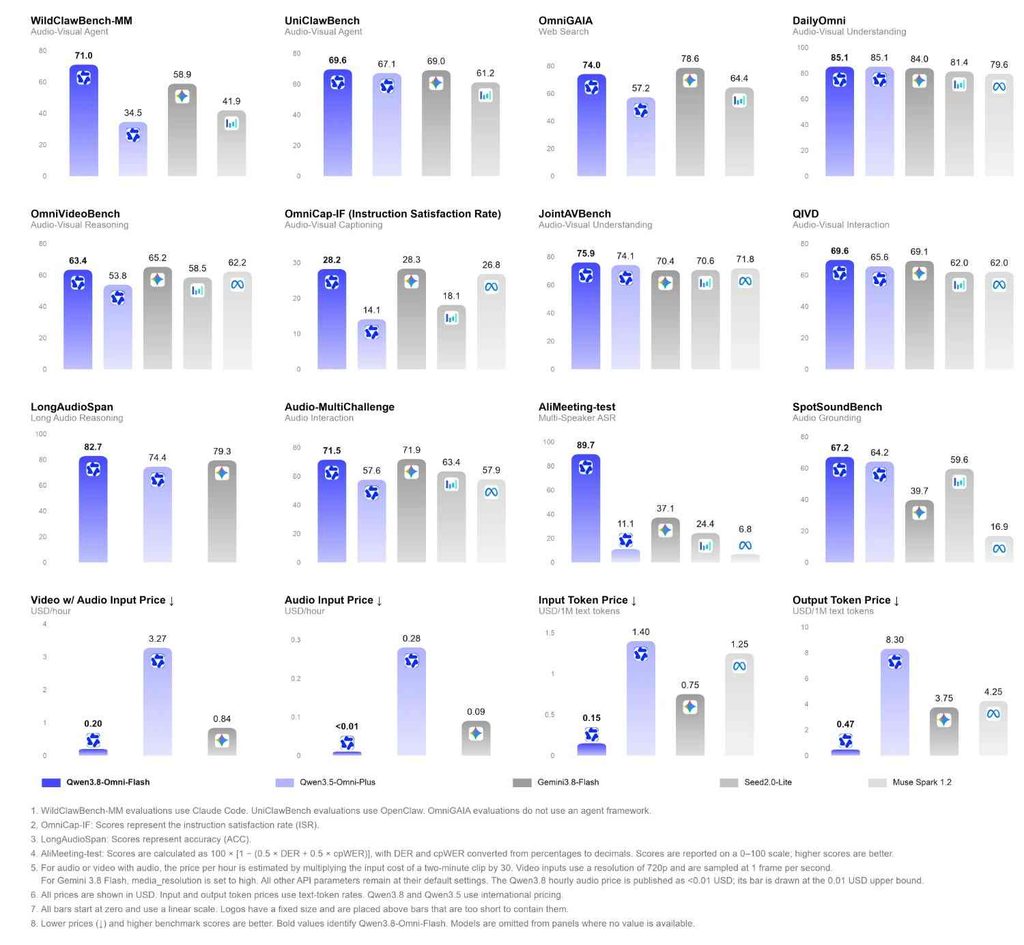
Qwen3.۸-Omni-Flash ورودیهای متنی، تصویری، صوتی و ویدیویی را در یک پنجره زمینه ۱ میلیون توکنی پردازش میکند. طبق نتایج اعلامشده، میانگین امتیاز این مدل در ۲۹ ارزیابی بیش از ۲۵ درصد بالاتر از Qwen3.۵-Omni-Plus است.
Alibaba همچنین اعلام کرده قیمت API برای هر ساعت ورودی صوتی بیش از ۹۸ درصد و برای ورودی صوتیتصویری بیش از ۹۳ درصد کاهش یافته است. در ارزیابیهای مربوط به عاملهای صوتیتصویری، برنامهنویسی و وظایف طولانی، این مدل در WildClawBench-MM بهبود ۳۶.۵ امتیازی و در AgenticVBench بهبود ۲۲.۳ امتیازی نسبت به Qwen3.۵-Omni-Plus داشته و در UniClawBench امتیاز ۶۹.۶ را به دست آورده است.
این مدل درک صوت و ویدیوی طولانی، استدلال صوتیتصویری، تولید توضیحات برای محتوای صوتیتصویری و تشخیص چند گوینده را نیز بهبود داده است. Qwen میگوید عملکرد صوتیتصویری این مدل به Gemini ۳.۸ Flash نزدیک شده و عملکرد کلی آن در حوزه صوت از Gemini ۳.۸ Flash فراتر رفته است.
عامل هوشمند برای ویدیوهای طولانی
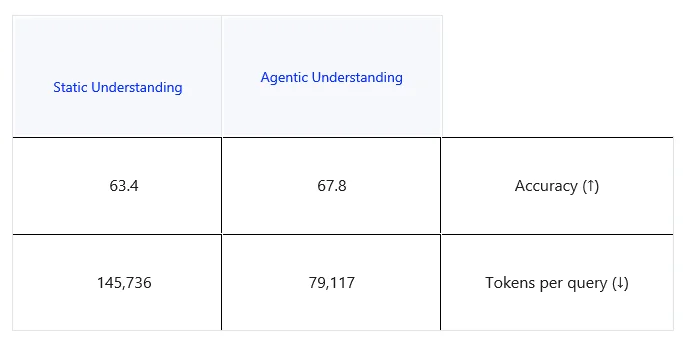
یکی از قابلیتهای Qwen3.۸-Omni-Flash، درک عاملمحور ویدیوهای طولانی است. بهجای پردازش کامل یک ویدیوی چندساعته، مدل میتواند ابتدا سؤال را بررسی کند، سپس مشخص کند کدام بخشهای ویدیو و صدا برای یافتن پاسخ اهمیت دارند و با چند مرحله جمعآوری شواهد، روی همان قسمتها تمرکز کند.
در OmniVideoBench، استفاده از این روش امتیاز دقت را از ۶۳.۴ به ۶۷.۸ رسانده و مصرف توکن را از ۱۴۵٬۷۳۶ به ۷۹٬۱۱۷ توکن کاهش داده است؛ یعنی حدود ۴۵.۷ درصد کاهش مصرف توکن.

تبدیل جلسات ویدیویی به اقدامات قابل اجرا
Qwen3.۸-Omni-Flash میتواند در جلسات چندنفره، گویندگان را از طریق صدا و تصویر شناسایی کند و تا یک ساعت ورودی صوتیتصویری را بهصورت بومی پردازش کند. این مدل قادر است تفکیک گویندگان، رونویسی محتوا و تطبیق هویت افراد را بهصورت یکپارچه انجام دهد.
بر اساس توضیحات Qwen، با دریافت ویدیوی کامل جلسه و یک درخواست مشخص، مدل میتواند روابط میان شرکتکنندگان را ترسیم کند، صورتجلسه بسازد، اقدامات موردنیاز را استخراج و ریسکهای پروژه را تحلیل کند. در ترکیب با عاملها و ابزارهای نرمافزاری، حتی امکان ارسال ایمیل، سازماندهی وظایف و شروع فرایند کدنویسی بر اساس نیازهای مطرحشده در جلسه نیز وجود دارد.
از تحلیل ویدیو تا پژوهش عمیق
Qwen3.۸-Omni-Flash میتواند محتوای یک ویدیو را در کنار نیاز کاربر بررسی کند و پرسشهایی را که نیازمند تحقیق بیشتر هستند شناسایی کند. سپس با جستوجو در منابع چندوجهی وب، از جمله تصویر، ویدیو و اسناد، اطلاعات مرتبط را گردآوری و در قالب یک گزارش پژوهشی متمرکز بر ویدیو ارائه میدهد.
تولید موزیکویدیو و ترجمه ویدیو
در قابلیت Music2MV، مدل ساختار، ریتم، حالوهوا، آواز و تغییرات سازهای یک آهنگ را تحلیل میکند تا در طراحی شخصیتها، صحنهها و نماهای موزیکویدیو مورد استفاده قرار گیرد. همچنین میتواند متن ترانه را در سطح خط و همراه با زمانبندی تولید کند تا هماهنگی میان آواز، زیرنویس و تصویر امکانپذیر شود.
در ترجمه ویدیوهای داستانی کوتاه نیز Qwen3.۸-Omni-Flash میتواند تشخیص گفتوگو بر اساس گوینده، ترجمه، شبیهسازی صدای شخصیتها، دوبله، میکس صدا و کنترل کیفیت نهایی را در قالب یک فرایند یکپارچه انجام دهد.
Qwen همچنین قابلیت تولید ویدیوهای نقد و تحلیل فیلمهای بلند را معرفی کرده است. طبق توضیحات این شرکت، عامل مبتنی بر مدل میتواند از درک فیلم و استخراج بخشهای کلیدی تا برنامهریزی نقد، تولید گویندگی و موسیقی، تدوین، رندر و بررسی نهایی را انجام دهد.
مدل بزرگ برای بهبود مدل کوچکتر
یکی دیگر از آزمایشهای Qwen3.۸-Omni-Flash، استفاده از خود مدل برای توسعه یک مدل کوچکتر است. Qwen به مدل وظیفه داده است که در مدت ۱۲ ساعت تشخیص گفتار لهجه سیچوانی در Qwen2.5-Omni-3B را بهبود دهد.
مدل بهصورت مستقل مجموعه ارزیابی WenetSpeech-Chuan را انتخاب، معیارهای ارزیابی را تعیین و عملکرد پایه را ایجاد کرد. سپس با بررسی نمونههای صوتی و نتایج تشخیص، مشکلات را شناسایی و داده آموزشی هدفمند تولید کرد.
در چهار دور آزمایش متوالی، این عامل ۳٬۴۱۳ نمونه آموزشی ایجاد کرد و بر اساس بازخورد ارزیابی، روش خود را تغییر داد، بهبودهای مؤثر را حفظ کرد و تلاشهای ناموفق را کنار گذاشت. در نهایت، نرخ خطای کاراکتری Qwen2.۵-Omni-3B در همان مجموعه ارزیابی از ۲۵.۷۹ درصد به ۱۵.۳۰ درصد کاهش یافت؛ یعنی حدود ۴۰.۷ درصد کاهش نسبی.
تبدیل ویدیوهای طولانی به دانش ساختاریافته
Qwen برای تبدیل محتوای ویدیویی به منابع قابل استفاده مجدد، قابلیت متنباز Video2Note را در مجموعه Qwen-MM-Plugins ارائه کرده است. این ابزار با درک همزمان گفتار، تصویر و مراحل انجام کار، دانش ویدیویی را سازماندهی میکند، مراحل کلیدی را استخراج و فریمهای نماینده را انتخاب میکند و در نهایت یادداشتهای PDF شامل متن و تصویر میسازد.
قابلیت متنباز Omni Skill Creator نیز میتواند از ویدیوهای آموزشی، ضبط صفحه یا نمایش نحوه انجام یک کار، رویههای استاندارد عملیاتی (SOP) استخراج کند و آنها را به مهارتهای قابل استفاده مجدد برای عاملها تبدیل کند.
Qwen3.۸-Omni-Flash-Realtime برای تعامل بلادرنگ
Alibaba در کنار مدل اصلی، Qwen3.8-Omni-Flash-Realtime را برای تعامل صوتیتصویری بلادرنگ معرفی کرده است. این مدل میتواند جریان زنده صدا و تصویر را دریافت و همزمان پاسخ تولید کند و بر اساس زمینه لحظهای، ابزارها را فراخوانی و وظایف را اجرا کند.
این مدل از WebSocket و WebRTC پشتیبانی میکند و برای کاربردهایی مانند تمرین مکالمه، تعامل صوتیتصویری و اجرای وظایف در لحظه طراحی شده است.
Qwen همچنین قابلیتی برای درک فضایی صدا معرفی کرده است که صدا را بهعنوان یک محور مکانی در کنار تصویر در نظر میگیرد. طبق ادعای شرکت، مدل میتواند جهت و فاصله منبع صوتی را همراه با موانع و مسیرهای قابل حرکت تشخیص دهد و بر اساس صدا، هدف را مکانیابی کند.
پشتیبانی از زبان فارسی
Qwen3.۸-Omni-Flash در بخش تشخیص گفتار از ۷۴ زبان و در بخش تولید گفتار از ۲۹ زبان پشتیبانی میکند. فارسی نیز در هر دو فهرست قرار دارد.
Qwen-MM-Plugins و Qwen-Live Harness متنباز شدند
Qwen برای استفاده از قابلیتهای چندوجهی مدل در محیطهای عاملمحور، مجموعه Qwen-MM-Plugins را توسعه داده است. این مجموعه از درک تصویر، صوت، ویدیو و اسناد، حافظه برای ویدیوهای طولانی و تولید محتوا پشتیبانی میکند و با محیطهایی مانند Codex، Claude Code، Qwen Code، Gemini CLI، Qoder، CodeBuddy و OpenClaw سازگار است.
همچنین Qwen-Live Harness بهعنوان یک چارچوب متنباز برای کار با API بلادرنگ Qwen3.۸-Omni-Flash-Realtime عرضه شده است. این چارچوب قابلیتهایی مانند واگذاری وظایف، تعامل پیشدستانه، حافظه بلندمدت و مدیریت زمینه را پوشش میدهد.
Qwen3.۸-Omni-Flash اکنون در پلتفرم Qianwen AI در دسترس است و API آن از رابطهای سازگار با استانداردهای OpenAI، از جمله Chat Completions و Responses API، پشتیبانی میکند.
منبع: Qwen
نتایج بنچمارک